

Адрес: Липецк, Площадь Победы, д.8, 1 этаж, (Здание "Липецкгражданпроект")
E-mail: myiz90x@gmail.com
Часы работы: Пн-Пт с 8:00 до 17:00
Поиск по скану семейного документа: почему OCR ошибается в фамилиях и как проверить результат

Сканирование создаёт изображение документа. Поисковый слой и проверенная расшифровка — отдельные этапы работы.
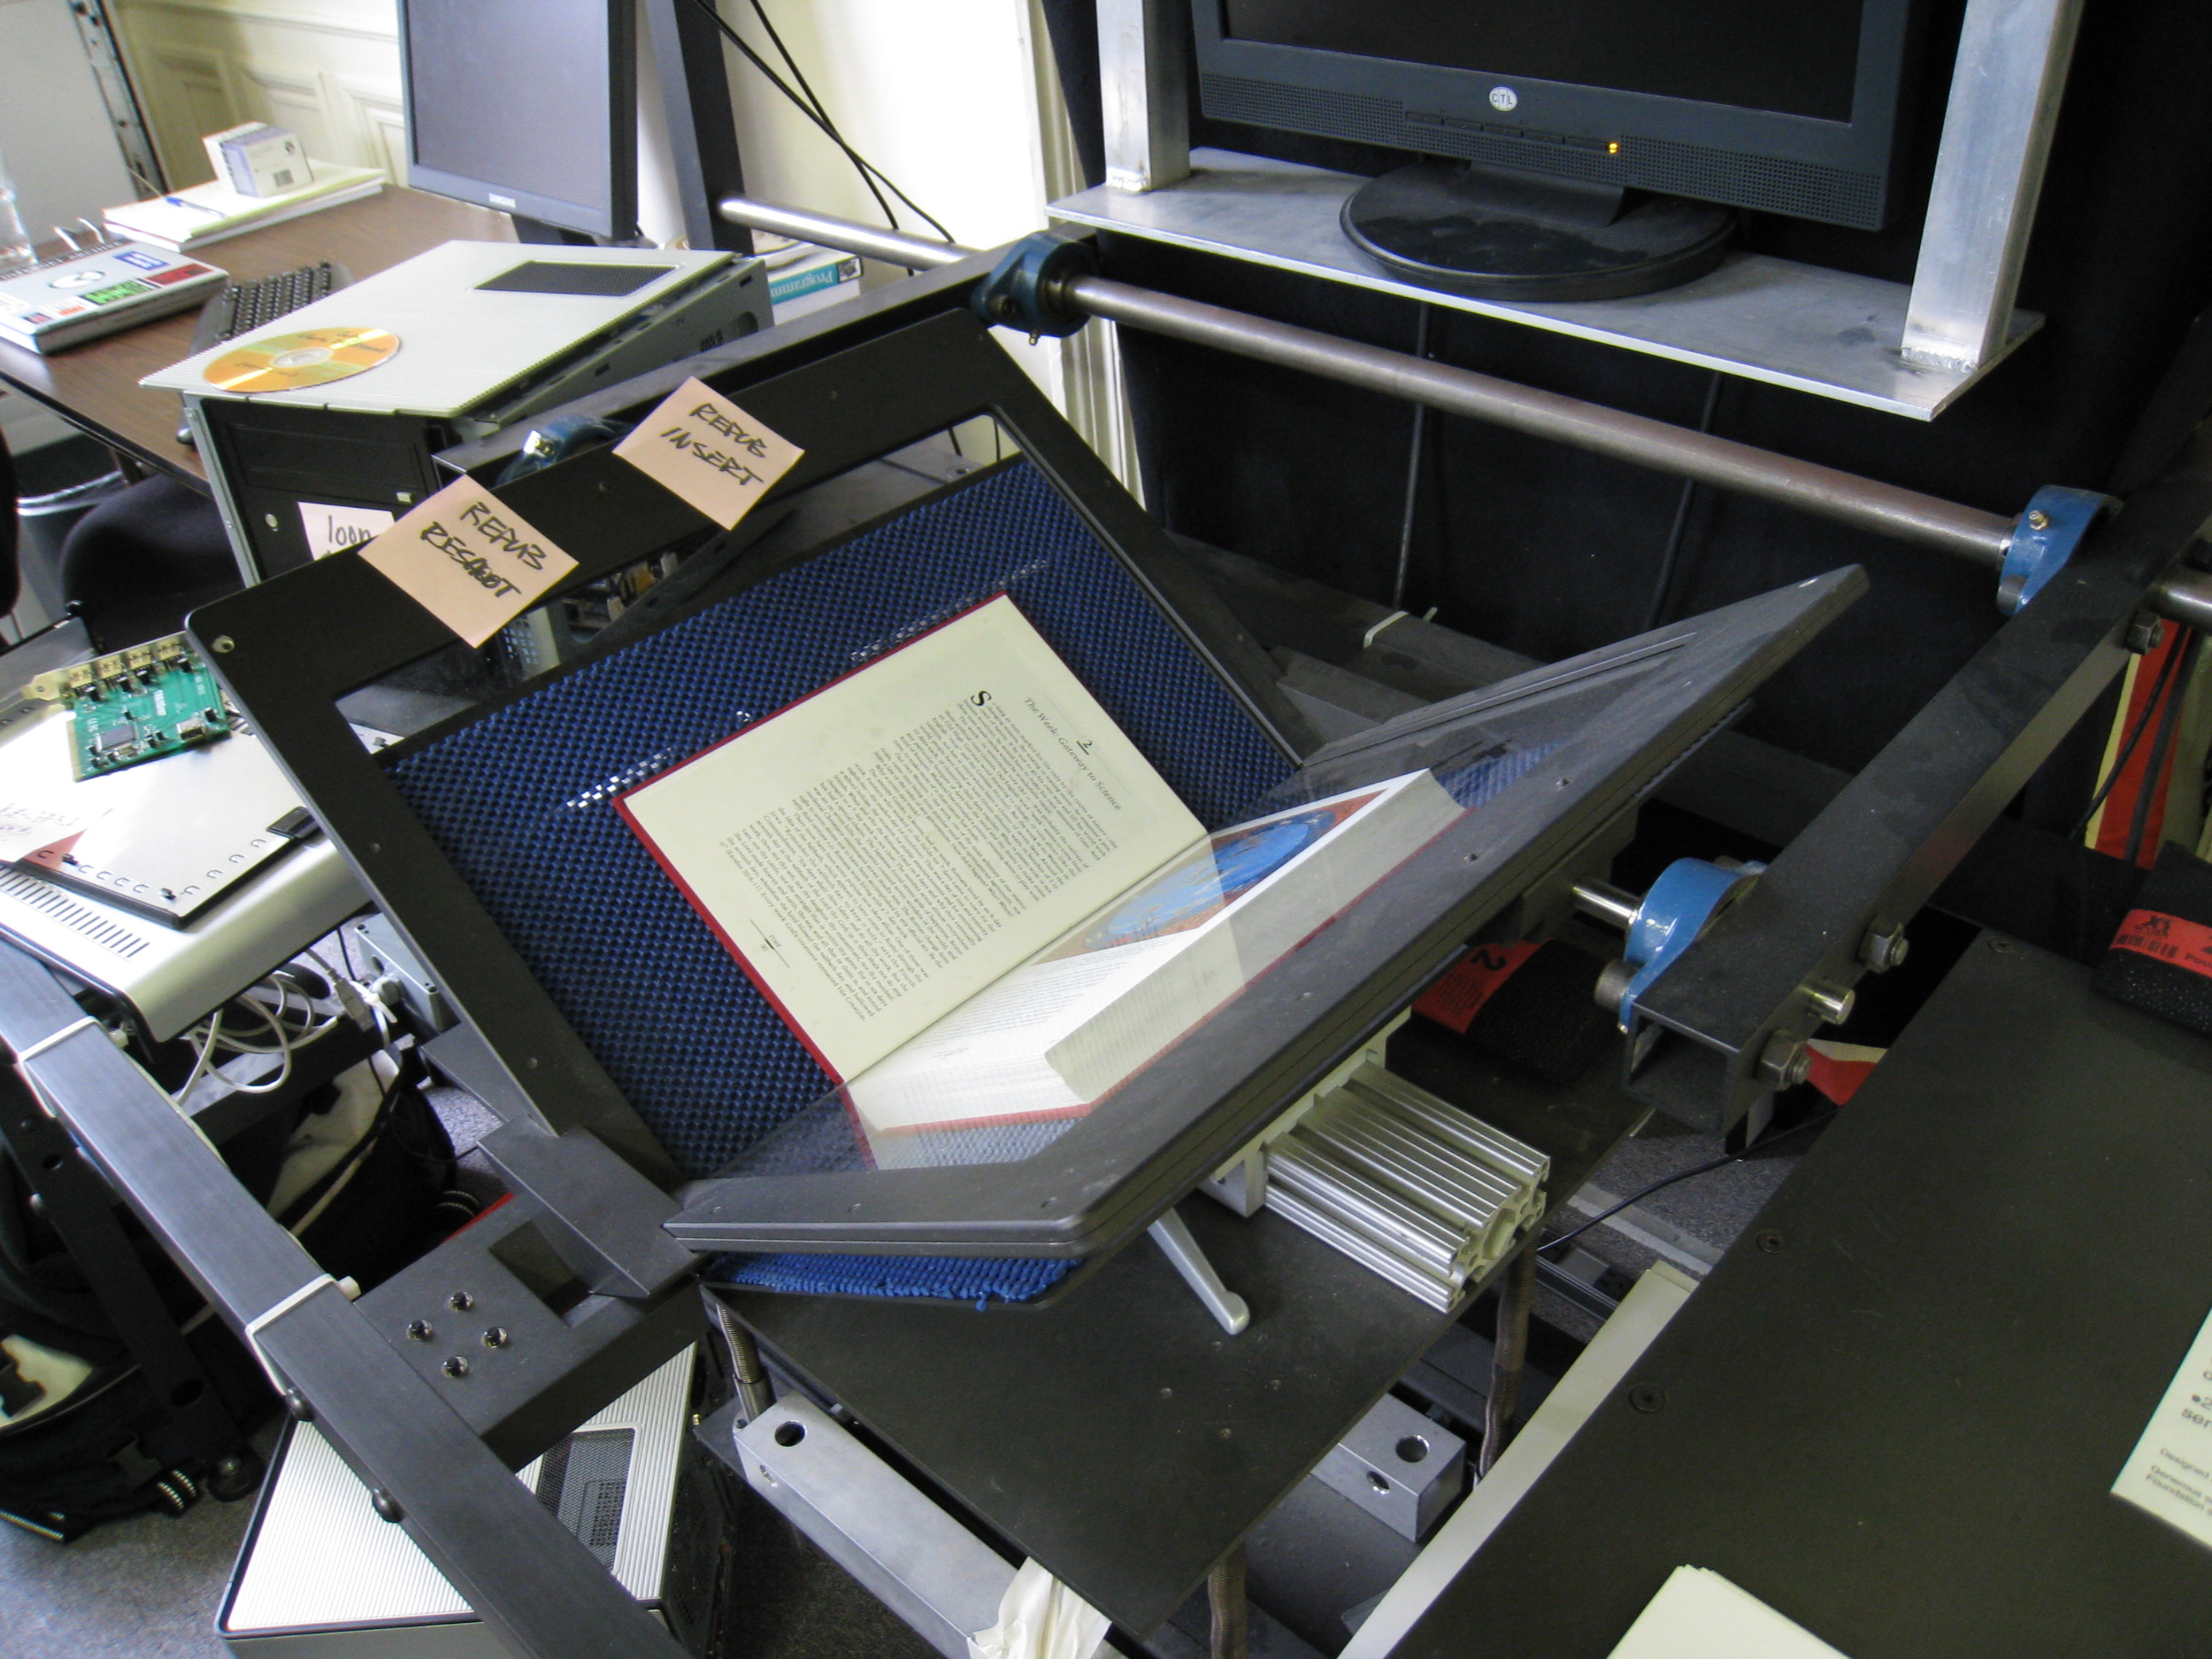
Gunnar Creutz · Wikimedia Commons · CC0. Полная опубликованная версия; без дополнительного кадрирования студией. Иллюстративный материал; не фотография заказа клиента.
Красивый скан не обязательно содержит доступный для поиска текст
В PDF может находиться только изображение страницы. Чтобы искать слова или выделять распознанные строки, обычно нужен дополнительный текстовый слой, полученный OCR. Он не появляется автоматически от самого факта сканирования.
Adobe отдельно описывает преобразование изображения в распознанный текст.[1] При этом появление выделения мышью не доказывает, что каждая буква прочитана правильно. За видимой фотографией фамилии может скрываться ошибочная последовательность символов.
Для семейных документов это особенно существенно: один неверный знак способен скрыть нужную запись от поиска. Поэтому полезно сразу различать изображение оригинала, результат распознавания и проверенную человеком расшифровку.

- ИзображениеКак выглядит исходная страница
- OCRЧто автоматически прочитала программа
- ПроверкаЧто сверено с изображением
Почему имена и даты требуют особого внимания
Редкая фамилия, инициалы и сокращённое название места дают меньше контекста, чем обычная фраза. Программа может спутать похожие буквы и цифры или предложить знакомое слово вместо нужного имени.
Начните проверку с полей, ради которых сохраняли документ: фамилия, имя, дата, населённый пункт, номер записи. Читаемость остального абзаца не подтверждает эти сведения автоматически.
Не исправляйте необычное написание только потому, что современный вариант выглядит привычнее. Сначала проверьте сам оригинал. Если нужна нормализованная форма для семейного указателя, запишите её отдельно от дословной передачи документа.
- ЛюдиФамилии, имена и инициалы
- ВремяДаты и числовые обозначения
- МестоНаселённые пункты и адреса
Как подготовить материал для распознавания
Проверьте полноту кадра, резкость, ориентацию и отсутствие глубоких теней. Если строка обрезана, никакое распознавание не возвращает её как достоверно прочитанную. Для слабого текста важно иметь достаточно подробную исходную копию.
Выберите язык распознавания, соответствующий документу, если программа позволяет. Для смешанного материала отдельно учитывают разные языки и необычные знаки. Не следует автоматически считать старую орфографию ошибкой оригинала.
Рукопись, повреждённый текст и печатная страница — разные по сложности случаи. Возможности конкретной программы нужно оценивать на пробе. Сохраните исходное изображение до любых усилений контраста и автоматической очистки.
- ИзображениеПолный кадр и нужная детализация
- НастройкаПодходящий язык и диапазон страниц
- ПробаПроверить сложный фрагмент
Почему таблица может читаться в неправильном порядке
Программа способна распознать большинство букв, но перепутать порядок столбцов. В списке жильцов фамилия и дата тогда окажутся связаны неверно. Для семейного исследования такая ошибка опаснее одной заметной опечатки.
Проверяйте строку целиком: имя, соседние поля, заголовки и перенос на следующую страницу. Если таблица содержит повторяющиеся фамилии, сравнивайте дополнительные признаки, а не выбирайте первое совпадение поиска.
В рабочей расшифровке полезно сохранять понятные строки и указание страницы. Выгруженный текст без разметки можно использовать для поиска, но выводы по нему следует сверять с изображением таблицы.

Как проверять, если программа отмечает сомнительные слова
Некоторые инструменты предлагают список подозрительных фрагментов. Adobe описывает сравнение распознанного слова с изображением и ручное исправление.[2] Это помогает найти часть проблем, но не является гарантией, что остальные слова верны.
Проверьте важные поля независимо от автоматических отметок. Полезный приём — поискать в PDF известную фамилию, затем выделить её и вставить в обычный текстовый редактор. Так становится видно, какие символы находятся в слое.
После исправления повторите поиск. Если документ понадобится родственникам, объясните, какие части проверены полностью, а какие остались только результатом OCR. Не обозначайте весь файл как вычитанный по проверке двух страниц.
- НайтиИзвестную фамилию или дату
- СравнитьСлово и изображение страницы
- ИсправитьПодтверждённые ошибки
- ПовторитьПроверить поиск после изменения
Что писать, если слово невозможно прочитать уверенно
Оставьте понятную пометку: «неразборчиво», «предположительно» или несколько вариантов с вопросом. Укажите страницу и место фрагмента. Это честнее, чем превращать догадку в установленное имя родственника.
Можно сверить повторяющееся слово на других страницах и спросить человека, знакомого с почерком. Однако семейное ожидание не подменяет видимый текст. Если два источника расходятся, сохраните сам факт расхождения.
Не просите систему автоматически дописать отсутствующую строку как будто она прочитана с бумаги. Реконструкция возможного смысла и расшифровка сохранившегося оригинала имеют разный статус. В архиве они должны оставаться различимыми.

Как хранить скан, OCR и исправления вместе
Оставьте исходное изображение, поисковый PDF и при необходимости проверенную расшифровку отдельными понятными файлами. Свяжите их общим обозначением документа и страниц.
| Версия | Что в ней хранится |
|---|---|
| Исходный скан | Вид страницы без подмены текста |
| Поисковый PDF | Изображение и распознанный слой |
| Расшифровка | Текст с пометками и уточнениями |
| Описание | Источник, страницы, объём проверки |
На телефоне таблицу можно прокручивать вбок.
В описании не требуется длинный отчёт. Достаточно указать, кто и когда сверял важные поля, где остались сомнения и к какому оригиналу относится комплект.
- ИсточникСкан нужной страницы
- СвязьОдинаковый номер документа
- СтатусПонятно, что проверено человеком
Что согласовать при сканировании в Липецке
Расскажите студии «Мы из 90х», какие материалы нужно сохранить: отдельные листы, книгу, печатный текст или рукописные страницы. Укажите объём и цель: чтение, поиск по фамилиям либо подготовка к дальнейшей расшифровке.
Сканирование, OCR и ручная проверка — отдельные вопросы состава заказа. Наличие услуги сканирования не следует понимать как автоматическое обещание безошибочно распознать любой почерк. Сначала согласуют необходимый результат.
Для семейной истории ценен комплект, который можно проверить по оригинальному изображению. Удобный поиск помогает находить сведения, а сохранённый скан позволяет убедиться, что программа прочитала их правильно.
